
到目前為止,我們學了不少觀察、解讀與介入模型內部的方法。不過,一路上的研究對象,大多還是 Transformer-based language models。但 AI 並不只有語言模型。影像模型從畫面中辨認物體,語音模型處理聲音,機器人則需要根據感測資訊採取行動。再把視野拉遠一點,人類與其他動物,也都在透過各自的方式學習、理解並回應世界。這些系統接觸的資料、學習方式與內部構造都不一樣。但它們、我們面對的世界,是同一個世界。那麼,不同系統會不會各自學出某些相似的表示?還是即使做出相近的判斷,內部處理資訊的方式也完全不同?今天先從不同 AI 模型之間的比較開始。我們要解決的第一個問題還不是「它們像不像」,而是兩個模型連 activation 的維度都不同,到底要怎麼比?
想像你把一張台北市地圖旋轉 90 度。台北車站的橫座標變了,台北 101 的縱座標也變了,但兩個地點之間的距離沒有因此改變。如果只比較兩張圖的 x、y 數值,可能覺得它們差很多;如果比較地點之間的關係,卻能看出它們其實畫的是同一張地圖。
模型的 representation 也有類似問題。Model A 用 768 個數字表示一句話,Model B 用 1,024 個數字;即使維度剛好相同,Model A 的第 315 個座標,也沒有理由對應 Model B 的第 315 個座標。因此,直接把兩個模型的 activation 相減,或計算它們的 cosine similarity,通常沒有明確意義,因為我們還沒有建立兩套座標之間的對應。
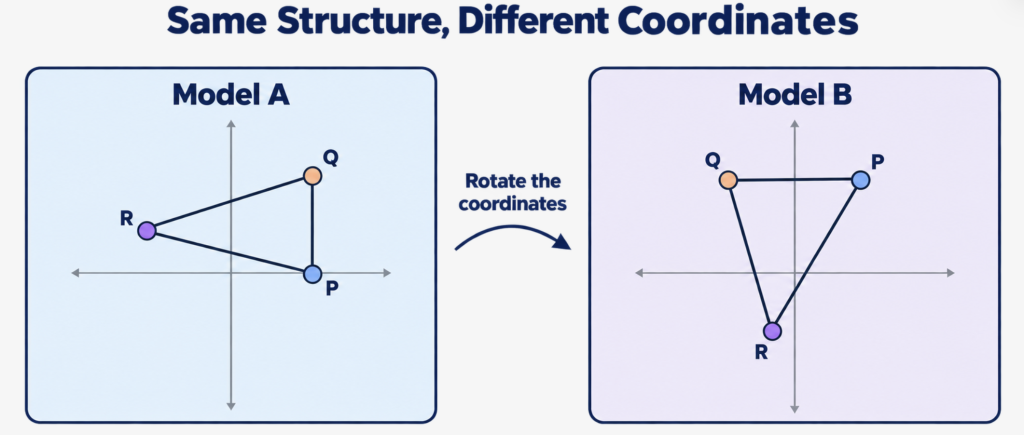
我們可以換個視角,先不要比較「同一句話在兩個模型裡的座標」,而是比較「兩個模型如何安排同一批句子之間的關係」。例如,模型 A 覺得狗和貓的描述很接近,那模型 B 是否也如此?
假設我們準備五個句子:
A dog is running.
A cat is sleeping.
Taipei is a city in Taiwan.
Taichung is a city in Taiwan.
This Python function raises an error.
分別把它們輸入兩個模型,在選定的 layer 中,每個句子取出一個 representation。
這裡要先做一個選擇:一句話有很多 tokens,要取哪一個位置?對 causal language model,可以取最後一個非 padding token 的 activation,也可以把有效 tokens 的 activations 做平均。兩者回答的問題不完全相同,不能在兩個模型之間隨意混用。不同模型的 tokenizer 也可能把同一句話切成不同數量的 tokens,所以「兩邊都取第 5 個 token」不保證是在比較相同文字位置。今天先以句子為比較單位,固定取樣方式,避開直接配對 token 編號的問題。最後會得到兩個矩陣:

每一列是一個句子,每一欄是一個 activation dimension。兩邊的欄數可以不同,但第 i 列必須對應同一個句子。這個配對是後面所有比較的基礎。
Representational Similarity Analysis(RSA)的想法是:先在每個模型內部建立一張距離表,再比較兩張表。[1] 以 Model A 為例,我們計算每一對句子的 representation distance。若選擇 cosine distance,就是:
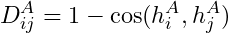
把所有配對排成矩陣,就得到 Representational Dissimilarity Matrix,簡稱 RDM。矩陣的第 i 列、第 j 欄,表示第 i 個句子和第 j 個句子的距離。對角線是句子和自己的距離,因此是 0;上半部和下半部則是重複資訊。
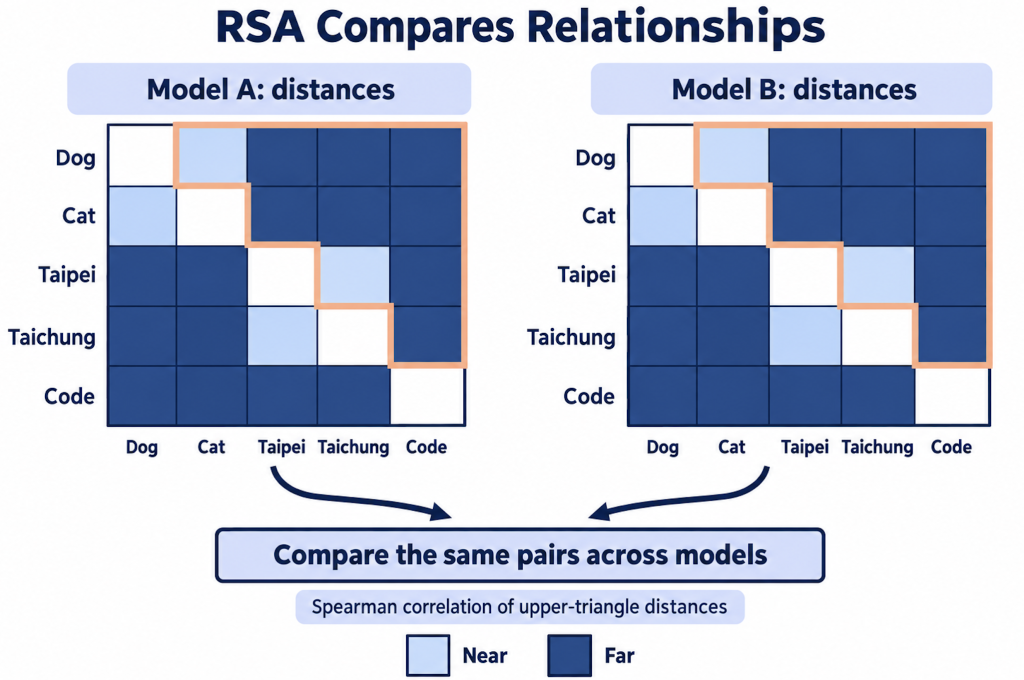
接著取出兩張矩陣不含對角線的上三角,把相同句子配對的距離排在相同位置,再計算相關性。例如使用 Spearman correlation:
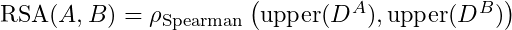
Spearman 比較的是排序。它問的不是兩邊的距離是否一模一樣,而是:在模型 A 中比較接近的句子配對,在模型 B 中是否也比較接近?例如,兩個模型都把狗與貓的描述排得比狗與程式碼更近,就會增加這種一致性。但真正的分數會比較所有句子配對,不只這幾個直覺例子。這樣一來,兩個模型即使使用不同維度,也能比較。它們各自把高維 representation 轉成同樣大小的 N × N 距離表,不需要先找到 neuron 之間的一一對應。RSA 最初就是為了連接不同系統的研究而發展的,包括模型與腦部量測。[1] 今天我們先用它比較 AI 模型,下一篇還會用到這個想法。
Centered Kernel Alignment(CKA)也是常見的 representation similarity 方法。[2] 它和剛才的 RSA 一樣,可以先把不同維度的 representations 轉成同樣大小的「樣本關係矩陣」,但比較關係的方式不同。這裡只介紹 linear CKA。先把兩個模型的 representation matrices 各自做 centering:每個欄位減去它在這批樣本上的平均值,得到 X 和 Y。接著計算:

K 和 L 都是 N × N 的 Gram matrices。每一格是兩個 centered representations 的內積,不是前一節的 cosine distance。Linear CKA 再比較兩個矩陣:
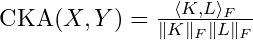
分子是把兩張矩陣對應格子的數值相乘後加總;分母則調整整體尺度。因為 X、Y 已經沿樣本維度做過 centering,這裡形成的 Gram matrices 也已經 centered。先不用記公式,只要區分今天用的兩個版本:
Linear CKA 不受座標旋轉、鏡射或整體等比例縮放影響,但不會忽略所有線性變換。如果把某一個方向拉長十倍、其他方向保持不動,CKA 就可能改變。[2] 因此,「兩個模型很像」一定要接著問:用哪種 metric、在哪一批 inputs 上比較?不同 metric 保留和忽略的差異不一樣,沒有一個分數能代替所有問題。
剛才只比較兩個模型各自的一層。但我們也可以把 Model A 的每一層,和 Model B 的每一層都比較一次,畫成 layer-by-layer heatmap。假設 Model A 的第 2 層,和 Model B 的第 3 層分數最高。意思是:在這批 inputs 與這個 metric 下,這兩層形成的 representation 結構最相近。它不代表兩層執行了相同的演算法,也不代表 Model B「想得比較慢」。有些資訊可能在多個 layers 中保留很久,因此一層可以同時和另一個模型的好幾層相似。Layer counts 不同時,也可以把深度標準化後比較,但相同的相對深度仍然不保證相同功能。Heatmap 的用途,是幫我們找到值得繼續分析的對應,而不是直接替每一層命名。
RSA 和 CKA 給我們的是相似度,沒有告訴我們怎麼把 Model A 的 activation 轉成 Model B 的座標。如果真的想搬運 representation,就需要學習一個 mapping。最簡單的例子,是用 paired inputs 訓練一個帶偏置的線性映射,也就是 affine map:
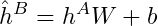
這裡把 h 寫成 row vector,因此 W 的大小是 d_A × d_B,b 則是 Model B 空間中的偏置。訓練時,每個樣本都有兩個目標明確的角色:Model A 的 activation 是輸入,Model B 對同一個 input 的 activation 是要預測的目標。最小化預測誤差,就能學出 W、b;實務上通常也會加上 regularization。
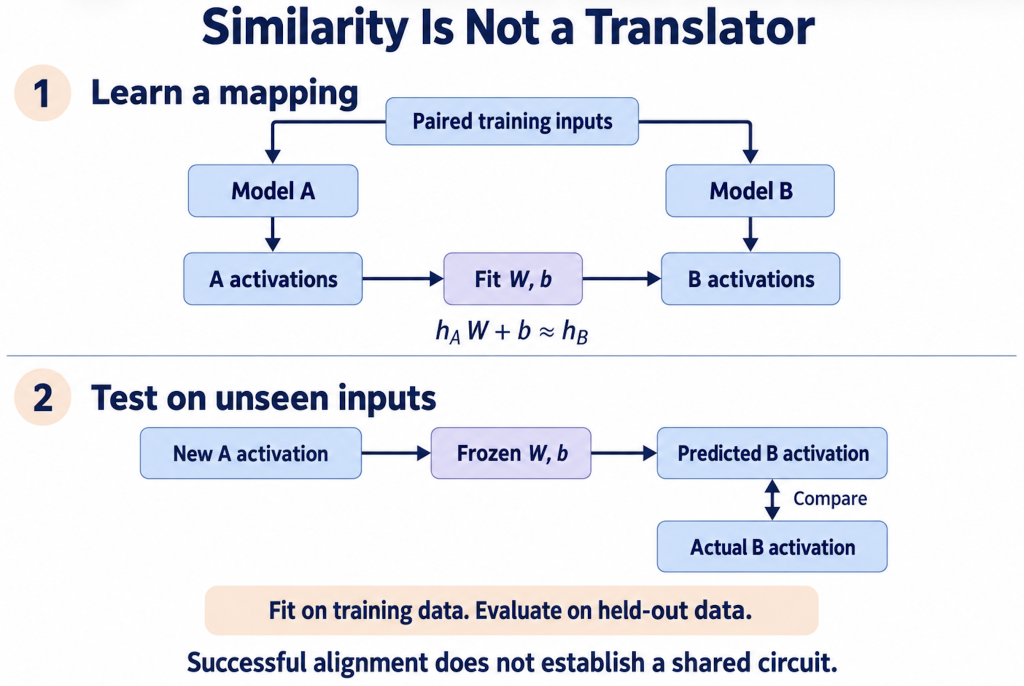
真正重要的是 held-out evaluation,而不是訓練資料上對得多漂亮。例如,把一句新句子的 A activation 映射到 B 空間後,能不能從一百個 B activations 中,找回同一句話?又或者,原本在 Model B 上訓練的 sentiment probe,能不能正確讀取 mapped activation?如果想主張能跨 concept 泛化,就還需要把某些 concepts 整組留到測試階段。只換句子措辭,不等於模型沒看過這個 concept。這些測試比單看 similarity 更進一步:我們開始檢查兩套表示之間的對應,是否能支援某個具體用途。
可以簡單的想像,如果一個簡單的線性 mapping 可以很好的翻譯、預測另一種模型的 representation,那可能會想到我們可以透過一個相對簡單的 transformation 對齊兩個模型的表徵,也就自然的接近我們一開始說的「Same structure, different coordinate」這件事。不過實際上,一般線性 mapping 也可能拉伸、壓縮,甚至丟掉部分資訊,因此不能直接說兩者只是同一套表示換了座標。並且單純看到 predicted activation 跟 actual activation 的 correlation 很高能告訴我們的 scientific insight 還是很有限,但相信不難想像他會有一些實用的價值(知道一個系統如何表示某個輸入,能不能預測另一個系統對同一個輸入的反應?),這點在明天我們將視角拉到 natural / biological intelligence (e.g. human brain) 時會更明確。
2025 年,Huang 等人研究了跨模型的 concept representations,嘗試用線性轉換,把一個模型的 steering vectors 搬到另一個模型。[3] 在他們測試的模型與概念中,這種轉換不只讓表示對齊,也能在目標模型中產生相應的行為控制效果;部分 mapping 還能泛化到未用來學習該 mapping 的 concepts,並出現由小模型向較大模型轉移 steering vectors 的結果。這比「兩張圖長得像」更有力,因為搬過去的表示確實能在另一個模型中發揮作用。不過,這是特定設定下的 transfer evidence,不是所有模型都能互換的保證。這裡也要分清楚我們搬的是什麼。如果 activation 的 mapping 是 hW+b,對應的 activation 差值就映射成 ΔhW:偏置 b 會在相減時抵消。Steering direction 和用來讀取 activation 的 probe weights,也不能不加區分地套用同一個轉換。另一項研究進一步測試:能不能把 Model A 的末端 hidden states 映射後,交給 Model B 原本的 output head 產生文字?Gorbett 與 Jana 的研究發現,某些模型配對確實可以,但效果受到來源模型能力與 tokenizer 相容性等因素限制。[4] 值得注意的是,這篇論文 2026 年 9 月的更新版本把相容性主要定位在最後一兩層。這比較支持「接近輸出時的表示可以對接」,不能直接當成兩個模型共享中間推理過程的證據。
2024 年,Huh 等人提出 Platonic Representation Hypothesis:不同模型隨著能力提升,可能逐漸形成共享的、關於現實世界的統計表示。[5] 直覺是,不同模型雖然從不同資料學習,但資料背後有共同的世界結構。語言模型從文字學到狗和貓的關係,影像模型從照片學到動物的外觀;如果兩者都越來越能掌握這個世界,內部表示是否也會越來越相似?跨模態比較時,不能把一張狗的照片和一句不相干的文字隨意配在一起。研究者需要成對的資料,例如圖片與對應 caption,再比較兩個模型如何安排這批樣本的關係。這裡還有一種很直觀的比較方式:不要求所有距離都一致,只問「鄰居是不是同一批」。例如,對某個樣本,模型 A 找出的三個最近鄰居是 P、Q、R,模型 B 則是 P、Q、S。兩邊共享兩個鄰居,overlap 就是 2/3。對所有樣本重複這件事,可以得到整體的 neighborhood alignment;每次搜尋都排除樣本自己。原始 Platonic Representation Hypothesis 研究就使用了這類 nearest-neighbor 比較。[5] 因此,它不是在主張「模型的 neuron 數值最後會完全一樣」,也不該被簡化成只依賴 CKA 的論點。
但「模型越大,similarity 越高」還需要小心檢查。第一個問題是維度與樣本數。對某些 metrics,尤其常用的 biased linear CKA,在樣本數固定、表示維度增加時,即使兩套表示彼此獨立,分數的隨機基準也可能上升。不同 metrics 不一定有相同的偏差,不能一概假設 baseline 都是 0。
第二個問題更直覺:搜尋的機會變多了。兩個模型各取 10 層,需要比較 100 組;各取 100 層,就有 10,000 組。如果最後只報最高分,後者有更多機會碰到一個很高的數字。這和抽獎次數更多、比較容易抽到大獎有點像。2026 年,Gröger 等人針對這些問題重新檢查跨模型、跨模態的相似性。他們在測試設定中發現,校正後,全域 metrics 原本隨規模增長的趨勢大幅減弱;local neighborhood 的對齊趨勢則較能保留。[6] 作者將這個較弱的主張稱為 Aristotelian Representation Hypothesis:不同模型可能逐漸同意「誰靠近誰」,但不一定收斂到相同的完整距離結構。
這不是已經推翻了所有 representation convergence,也不是說校正後模型之間完全沒有相似性。它讓問題變得更精確:我們看到的,是既有的非隨機相似,還是隨能力提升而持續增強的相似?保留下來的是局部鄰居關係,還是整個空間的幾何?
假設我們已經取得兩個模型對同一批句子的 activations,分別放在 H_a、H_b。每一列代表一個句子,兩邊列順序相同。以下程式直接示範今天的 cosine-distance Spearman RSA 與 centered linear CKA,不涉及模型載入:
import numpy as np
from scipy.spatial.distance import pdist
from scipy.stats import spearmanr

def rsa(H_a, H_b):
    # pdist 回傳不重複、不含對角線的配對距離。
    d_a = pdist(H_a, metric="cosine")
    d_b = pdist(H_b, metric="cosine")
    return spearmanr(d_a, d_b).statistic

def linear_cka(H_a, H_b):
    X = H_a - H_a.mean(axis=0, keepdims=True)
    Y = H_b - H_b.mean(axis=0, keepdims=True)
    K, L = X @ X.T, Y @ Y.T
    denominator = np.linalg.norm(K) * np.linalg.norm(L)
    if denominator == 0:
        return np.nan
    return np.sum(K * L) / denominator
這段假設每列 activation 都是有限且非零的向量,也有足夠的變化可供比較;全都相同的 representations 沒有可解讀的相關性。算出分數後,還要準備一個對照:保留 Model B 的 activations,但打亂它們和 Model A 的句子配對。
rng = np.random.default_rng(42)
observed = linear_cka(H_a, H_b)

null_scores = np.array([
    linear_cka(H_a, H_b[rng.permutation(len(H_b))])
    for _ in range(200)
])

print("Observed:", observed)
print("Shuffled median:", np.median(null_scores))
print("Shuffled 95th percentile:", np.quantile(null_scores, 0.95))
這個操作保留了每個模型自己的 representation 集合與內部幾何,只破壞「兩邊正在描述同一個句子」的對應。若亂配後分數仍然很高,原本的高分就不能只憑數值大小來解讀。這段程式適用於單一、事先選定的 layer pair,而且假設樣本可以互換。如果句子來自同一篇文章、同一個模板或同一段連續對話,就需要考慮群組依賴,不能直接把所有列當成獨立樣本亂洗。
如果真正報告的是「所有 layer pairs 中最高的分數」,每次 permutation 也要重新比較所有 layer pairs,並取最大值;同一次 permutation,要在 Model B 的各 layers 使用相同的句子重排。這樣才是在比較相同搜尋流程下,真實配對與亂配的差異。[6] Similarity controls 和 held-out alignment 是兩種不同的檢查:前者問配對關係是否提供額外訊號,後者問學到的 mapping 能否用在新資料上,不能互相替代。
走到這裡,我們可以把證據分成三個層次:
前兩個層次都很有價值,但不會自動推出第三個。同樣把狗和貓放得很近,一個模型可能比較依賴字詞共現,另一個模型可能更依賴語境整合。只看選定 layer 最後形成的幾何,還不知道上游是怎麼算出來的。
因此,representation comparison 不是替 circuit analysis 找到一條捷徑,而是讓我們開始問跨系統的問題:哪些資訊組織方式比較常見?哪些差異和架構、資料或訓練目標有關?我們在一個模型裡找到的線索,有多少能帶到另一個模型?是否有某些機制、原理是更接近「universal」的?
今天的方法,有一個很重要的特性:我們不需要假設兩個系統的內部單位一一對應。這也讓比較對象不必停在 AI 模型。對人和模型呈現相同的句子、故事甚至影片,分別量測腦部反應與 model activations,就能問:兩邊是否以相似方式區分這些內容?這是作者自己私心覺得很有趣的延伸主題,雖然與安全性的關係相對低,但不論是對神經科學、甚至腦機介面的實用價值或是單純出於好奇,都是一個很令人興奮的主題。
但跨到人腦之後,還會遇到新的問題。腦部量測有自己的時間解析度與雜訊;模型的一個 token,也不會自然對應到一次腦部掃描。下一篇,我們就把今天的比較思路帶進這個更具挑戰性的場景:人腦和語言模型,究竟有哪些地方可以比較?看到相似之處又代表什麼?
[1] Kriegeskorte, N., Mur, M., & Bandettini, P. A., “Representational Similarity Analysis — Connecting the Branches of Systems Neuroscience”, 2008. https://www.frontiersin.org/journals/systems-neuroscience/articles/10.3389/neuro.06.004.2008/full
[2] Kornblith, S., Norouzi, M., Lee, H., & Hinton, G., “Similarity of Neural Network Representations Revisited”, ICML, 2019. https://proceedings.mlr.press/v97/kornblith19a.html
[3] Huang, Y., Huang, C., Feng, D., Lei, W., & Lv, J., “Cross-model Transferability among Large Language Models on the Platonic Representations of Concepts”, ACL, 2025. https://arxiv.org/abs/2501.02009
[4] Gorbett, M., & Jana, S., “Ventriloquist LLMs: Linear Alignment of Late-Stage Representations”, 2026. https://arxiv.org/abs/2603.18908v5
[5] Huh, M., Cheung, B., Wang, T., & Isola, P., “The Platonic Representation Hypothesis”, 2024. https://arxiv.org/abs/2405.07987
[6] Gröger, F., Wen, S., & Brbić, M., “Revisiting the Platonic Representation Hypothesis: An Aristotelian View”, 2026. https://arxiv.org/abs/2602.14486



 iThome鐵人賽
 看影片追技術